Agentes autónomos26 Oct 2026
Bots que trabajan solos
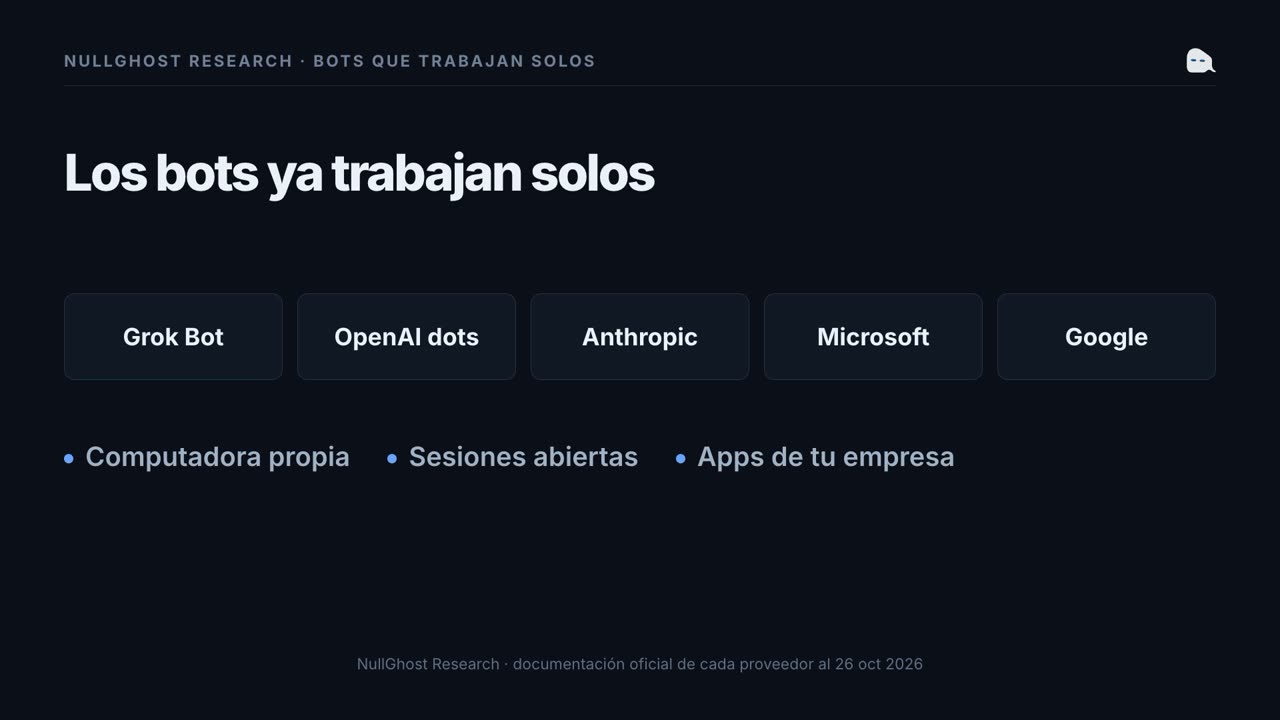
Cómo gestionan hoy xAI, OpenAI, Anthropic, Microsoft y Google a sus agentes autónomos, y quién responde por lo que hacen.
Un modelo pequeño dejó de llamar sus herramientas. Parecía un límite de herramientas; era un recorte silencioso del prompt.
Antes de concluir que un modelo pequeño no sabe usar herramientas, revisa cuántos tokens recibió.
Un modelo de 9.7B pasó la prueba con una herramienta y no llamó ninguna con las 24 de un agente. La petición pesaba 14,095 tokens y el servidor, con su ventana por defecto de 4,096, la recortó a unos 2,050 sin avisar, justo donde van los esquemas de las herramientas. Con la ventana en 32,768, la misma petición produjo una llamada correcta en 10 de 10 intentos, y el barrido de 1 a 24 herramientas quedó plano. Bajar la temperatura no cambió nada. Un control sintético con una sola herramienta, alargando el prompt hasta el tamaño de 24, falla y acierta exactamente donde lo hace la petición de 24: lo que decide es el tamaño del prompt contra la ventana, no el número de herramientas.
Se capturó la petición del agente con un proxy local, se reprodujo diez veces por condición contra el mismo modelo y se contrastó con un control sintético que separa el número de herramientas del tamaño del prompt. Es un modelo (Qwen3.5 9B), una versión de servidor (Ollama 0.33.2), una máquina y una tarea; con diez intentos se distingue 0 de 10 de 10 de 10, no las diferencias pequeñas. No se registró la configuración original del servidor el día de la falla. Una versión anterior de este trabajo hablaba de un precipicio de herramientas; esa afirmación era incorrecta y estas mediciones la reemplazan.
Cómo gestionan hoy xAI, OpenAI, Anthropic, Microsoft y Google a sus agentes autónomos, y quién responde por lo que hacen.
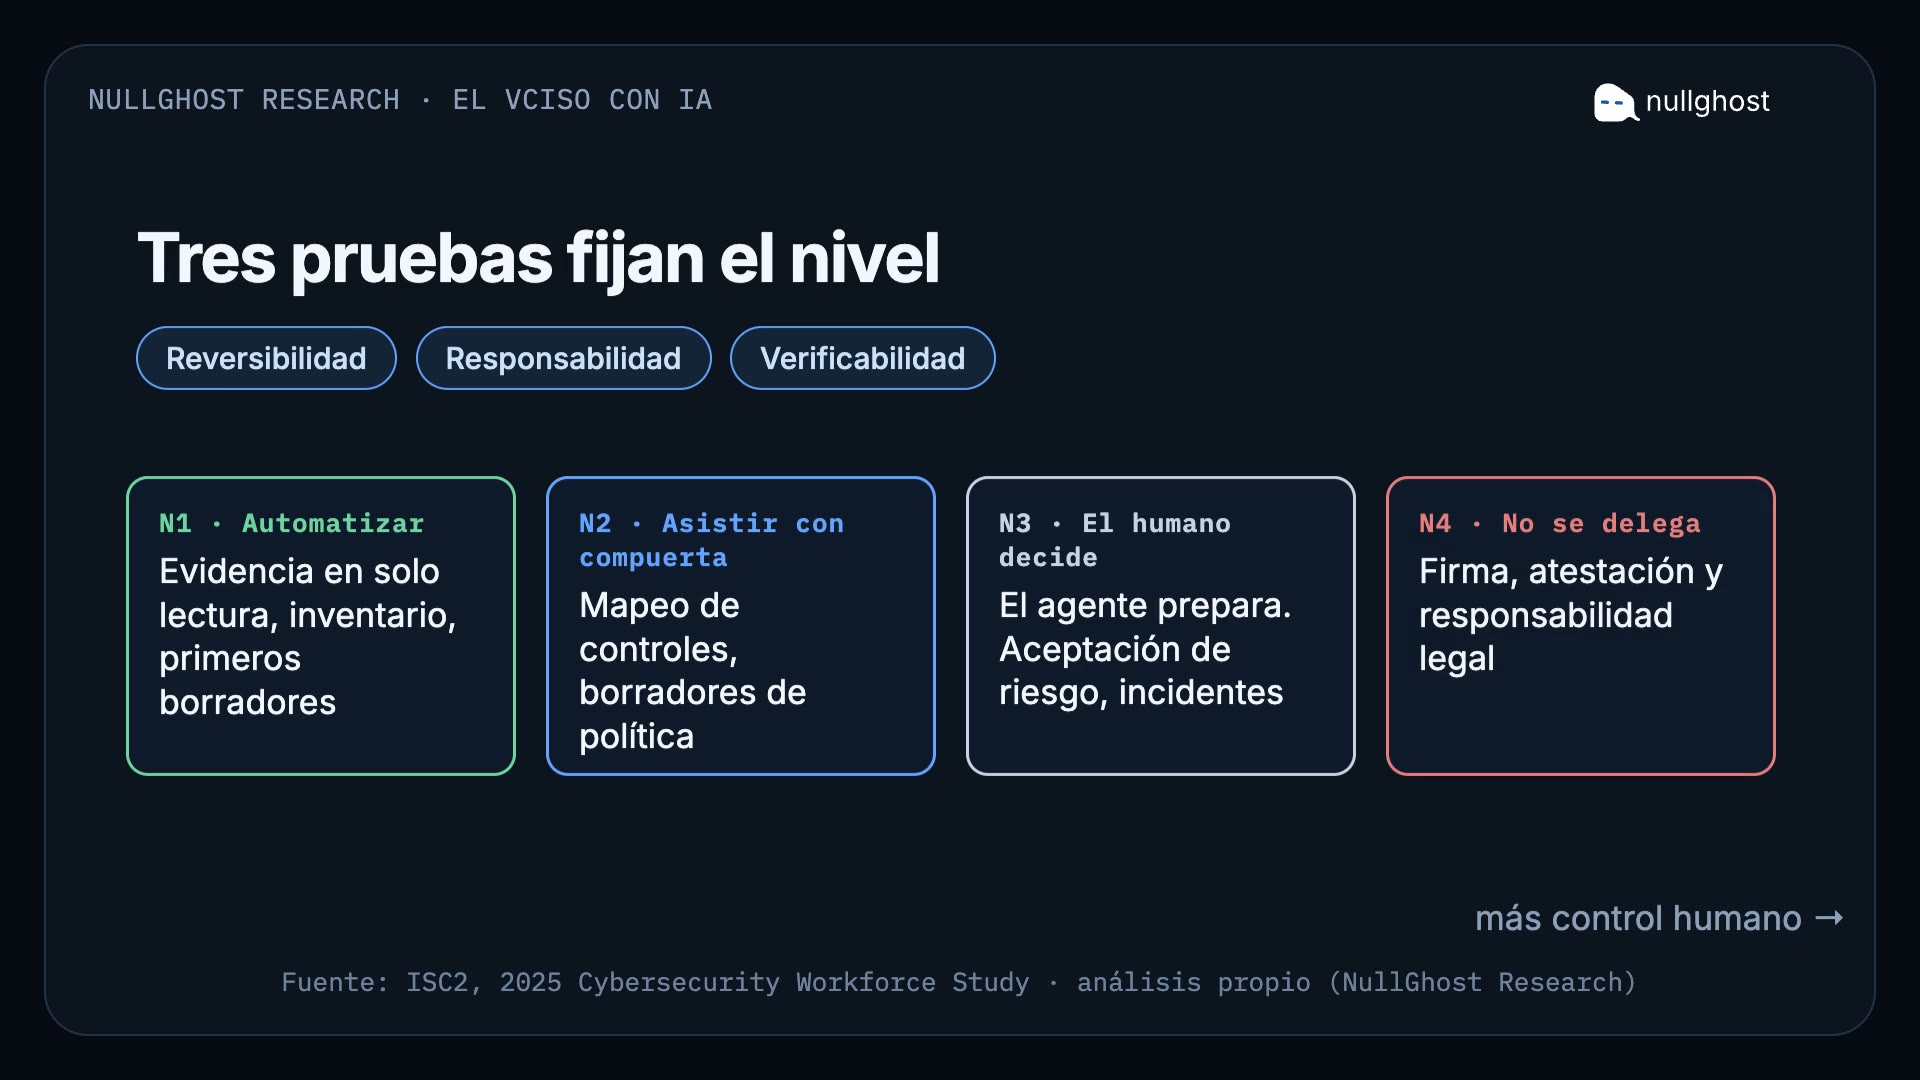
Qué se delega a un agente, qué se verifica y qué no se puede delegar. Una escalera de cuatro niveles y un protocolo de medición, con fuentes y límites explícitos.
Qué se ha medido, qué se ha proyectado y qué se ha legislado. Cada fuente va marcada por su nivel de verificación y no se promete ninguna fecha.